你根据给出的 README 成功构建了一个最简单的 Path Tracing Renderer 渲染出来了自己的第一个 Cornell Box,并且心怀忐忑的将答卷交到了 CGLab 的邮箱中去,虽然最终结果看起来很丑陋,整幅图都是噪点,而且渲染出来的速度非常慢,但是说到底也是渲染出来了。
在你提交过后,整个密室发出强光并且开始消失,你回过神来发现自己还在教室中睡觉,一样的环境一样的时间。
但唯一不同的是同学们还走完,最后除了你要走的是麦秧,一位女生,粉色的长发,披下来大概到肩膀往下一点点,像柔软的丝绸让人止不住想触摸,不过平时看见她都是扎起来的,肤白的脸蛋看见她就觉得可爱,一双双晶莹剔透的黑色眼眸,和你穿着同样的制服,只不过你的是长裤,而她是裙子。
她回过头向你微笑了一下,像是对你的某种肯定,并对你说:“继续加油哦,Gemini”,随后发出嘻嘻嘻的笑声,让你感到非常诧异,因为身为班上最不起眼的人之一的你,一位像天使一样的女孩居然对着你微笑还尽说些莫名奇妙的话 Gemini 不是 google 的 ai 大模型吗,怎么对我说 Gemini 好像是叫我一样,怎么想都想不明白,想破脑袋也想不明白。
她什么都没说向教室外走去。想知道原因,非常想知道,快速起身追了上去。
“麦秧,你刚刚说的话什么意思啊,莫名奇妙的?Gemini 又是什么意思啊”
“Gemini 就是你哇,继续加油哦,渲染这条路可不简单,对了我还有事不要跟上来了”,她留下你一个人走开了。
而你大概也猜到了,麦秧也是 CGLab 中的一员,而自己的称号就叫 Gemini,为了搞清楚状况你决定继续研究这个PathTracing, 由于上次用到的物理知识和数学知识你一知半解,所以你这次决定系统的学习一下。
Radiometry# 在图形学渲染中我们最主流使用的是 Radiometry 中的物理概念,而物理是对我们现实世界中的数学描述,所以我们通过 Radiometry 就可以渲染出现实世界中真实的画面。
Energy# 我们在高中物理中都学过光是具有能量的,光的能量是由其波长决定的。λ \lambda λ Q Q Q
Q = h c λ Q = \frac{h c}{\lambda} Q = λ h c 其中
h h h c c c λ \lambda λ J J J
现代物理中我们的通常使用量子力学来描述光的各种性质,而在图形学中我们通常使用传统的几何光学,这已经足够了,我们主要是渲染宏观上光的行为,但波动性我们通常不会考虑。
Flux# Flux 指的是光源在单位时间内发出的能量,也就是功率是“能量流动的速率”,在图形学中我们通常考虑 Flux 而不是 Energy,因为我们主要关注的是某一瞬间的能量
通常使用 Φ \Phi Φ J / s J/s J / s W W W
Φ = lim Δ t → 0 Δ Q Δ t = d Q d t \Phi = \lim_{\Delta t \to 0} \frac{\Delta Q}{\Delta t}= \frac{dQ}{dt} Φ = Δ t → 0 lim Δ t Δ Q = d t d Q
扩展知识(了解后对认识后面的物理量有帮助):辐射度量学 Radiometry 要描述的是一个场,而场的核心特征是它在空间和时间中的连续分布和传输,也就是场目前的状态,我们并不关心这个场累计了多少的能量,而是能量在某一瞬间“穿过”它的速率——因为只有速率才能定义场在每一点的状态。能量是一个“过程量”,一个表面接收到的总能量取决于你测量了多久。功率是一个“状态量”功率是能量流动的瞬时速率,所以我们使用 Radiometry 这个物理工具更多是使用Flux这个状态量
Irradiance# Irradiance 被定义为在单位面积上瞬时通过的能量(简单说就是这个区域接收的Flux), 也就是单位面积上的功率,单位是 W / m 2 W/m^2 W / m 2 P P P
E ( P ) = lim Δ A → 0 Δ Φ ( P ) Δ A = d Φ ( P ) d A E(P) = \lim_{\Delta A \to 0}\frac{\Delta \Phi(P)}{\Delta A} = \frac{d\Phi(P)}{dA} E ( P ) = Δ A → 0 lim Δ A ΔΦ ( P ) = d A d Φ ( P )
根据Irradiance 我们知道在下面这副图中假设光源的 Flux Φ \Phi Φ r 1 r_1 r 1 r 2 r_2 r 2 r 1 > r 2 r_1 > r_2 r 1 > r 2 E 1 E_1 E 1 E 2 E_2 E 2
E 1 = Φ 4 π r 1 2 E_1 = \frac{\Phi}{4\pi r_1^2} E 1 = 4 π r 1 2 Φ E 2 = Φ 4 π r 2 2 E_2 = \frac{\Phi}{4\pi r_2^2} E 2 = 4 π r 2 2 Φ E 1 E 2 = r 2 2 r 1 2 < 1 \frac{E_1}{E_2} = \frac{r_2^2}{r_1^2} < 1 E 2 E 1 = r 1 2 r 2 2 < 1 所以我们可以得到结论,小球上的 irradiance 小于大球上的 irradiance
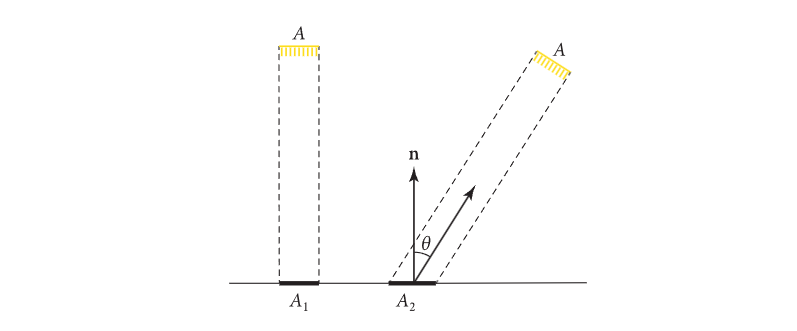
根据 Irradiance 我们还可以推导 Lambert 定律,该定律指出,到达表面的 Energe 与光线方向和表面法线之间夹角的余弦成正比,如下图所示A = A 1 < A 2 A = A_1 < A_2 A = A 1 < A 2 θ , A \theta,A θ , A A 1 , A 2 A_1,A_2 A 1 , A 2 Φ \Phi Φ
E 1 = Φ A E_1 = \frac{\Phi}{A} E 1 = A Φ 而右边由于A 2 = A cos θ A_2 = \frac{A}{\cos \theta} A 2 = c o s θ A
E 2 = Φ cos θ A E_2 = \frac{\Phi \cos \theta}{A} E 2 = A Φ cos θ Intensity# 还记得我们上面点光源球面的例子吗?如果当我们的光源的Flux不恒定或者更准确的说是在不同方向上的Flux是不同的,那么我们就没法用irradiance上面那个例子了,而Intensity彻底解决了这个问题,它是这么定义的:单位立体角的Flux,单位是 W / s r W/sr W / sr
I = lim Δ ω → 0 Δ Φ Δ ω = d Φ d ω I = \lim_{\Delta \omega \to 0} \frac{\Delta\Phi}{\Delta \omega} = \frac{d\Phi}{d\omega} I = Δ ω → 0 lim Δ ω ΔΦ = d ω d Φ 要清楚的是,Intensity和Irradiance是不同的,Intensity简单说是指定方向上的Flux,而Irradiance简单说是指定区域上的Flux
既然我们提到了点光源的例子,这里如果你的知觉非常的好的话,可以注意到当点光源的Flux恒定,在单位球面上的Intensity和Irradiance是相等的,这里自行证明吧
Radiance# 为了描述一根光线我们引入了 Radiance,Irradiance 表示的是从不同方向的光线(有很多光线)上射到这一点来,Intensity表示光源射向同一个方向的Flux(有很多光线),而为了表示从一个点出发(有很多方向可以出发)射向指定方向(规定唯一方向,那么就锁死一个光线了)的Flux,也就是单位立体角单位面积上的Flux,单位是W / m 2 s r W/m^2sr W / m 2 sr p p p ω \omega ω
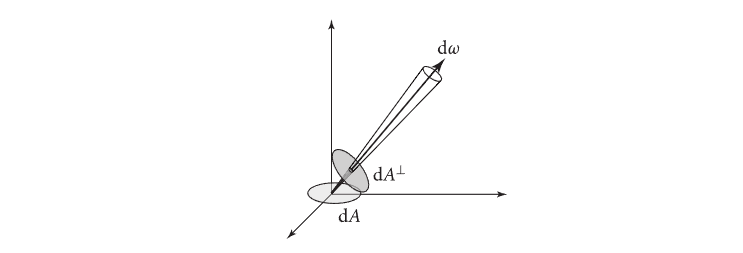
L ( p , ω ) = d 2 Φ ( p ) d ω d A L(p,\omega) = \frac{d^2\Phi(p)}{d\omega dA} L ( p , ω ) = d ω d A d 2 Φ ( p ) 而更准确的说Radiance定义为每单位立体角每单位投影面积上的Flux,因为这遵循了Lambert 定律,Radiance 要描述的是表面本身的“发光能力”,而这个能力,必须用从观察者视角“看起来”的有效面积来衡量,所以更准确的公式为
L ( p , ω ) = d 2 Φ ( p ) d ω d A ⊥ = d 2 Φ ( p ) d ω d A cos θ L(p,\omega) = \frac{d^2\Phi(p)}{d\omega dA^{\perp}} = \frac{d^2\Phi(p)}{d\omega dA\cos \theta} L ( p , ω ) = d ω d A ⊥ d 2 Φ ( p ) = d ω d A cos θ d 2 Φ ( p ) 还记得我们说过 Irradiance 表示的是来自不同方向上的光线(Flux光线的瞬时能量)到达了这个点P(微小的区域)吗?我们知道 Radiance 可以表示一个光线,所以我们可以把不同方向上的 Radiance (光线)积分起来就能得到 Irradiance ,这从微积分的角度出发是对的,从代数的推导出发也是这样。
E ( p ) = ∫ Ω L ( p , ω ) cos θ d ω E(p) = \int_{\Omega}L(p,\omega)\cos \theta d\omega E ( p ) = ∫ Ω L ( p , ω ) cos θ d ω 同理,Intensity 是一个方向上的所有的光线,那么我们可以用 Radiance 对所有射向ω \omega ω
I ( ω ) = ∫ A L ( p , ω ) cos θ d A I(\omega) = \int_{A} L(p,\omega)\cos \theta dA I ( ω ) = ∫ A L ( p , ω ) cos θ d A 我们需要建立起更直觉的对 Radiometry 的认识
我们通常表示一个瞬时的时刻
Flux 能量(瞬时/此刻)
Irradiance 一个点接受的能量(瞬时/此刻)
Intensity 一个方向上的能量(瞬时/此刻)
Radiance 一条光线(光线=能量)(瞬时/此刻)
BRDF# 我们已经定义好了光线,我们现实世界中并不是光直接射入我们的眼睛的,因为我们都知道我们看到的并不是一堆光源,而是各种不会自发光或者是发出的是波长不在可见光波长范围内的电磁波的非光源物体,学过高中物理的都知道,光大多是通过各种与物体的作用弹射到我们的眼睛中。所以我们还需要定义光线如何与物体作用,也就是物体的材质,为此我们需要对材质进行建模。
我们可以这样想:一根光线以某一个方向照射到一个物体的某个点上,光的能量有一部分会被吸收有一部分会以某个角度被反射出去,这就构成了材质。
我们假设这个算子是f r ∗ f_r^{\ast} f r ∗ x x x L i ( x , ω i ) L_i(x,\omega_i) L i ( x , ω i ) L o ( x , ω o ) L_o(x,\omega_o) L o ( x , ω o )
L o ( x , ω o ) = f r ∗ ( x , ω i , ω o ) L i ( x , ω i ) L_o(x,\omega_o) = f_r^{\ast}(x,\omega_i,\omega_o) L_i(x,\omega_i) L o ( x , ω o ) = f r ∗ ( x , ω i , ω o ) L i ( x , ω i ) 但我们现实中不可能只有一条光线,所以我们需要引入微分,即在入射方向为d ω i d\omega_i d ω i
d L o ( x , ω o ) = f r ∗ ( x , ω i , ω o ) L i ( x , ω i ) d ω i dL_o(x,\omega_o) = f_r^{\ast}(x,\omega_i,\omega_o) L_i(x,\omega_i)d\omega_i d L o ( x , ω o ) = f r ∗ ( x , ω i , ω o ) L i ( x , ω i ) d ω i 我们知道
d E ( p ) = L ( p , ω ) cos θ d ω dE(p) = L(p,\omega)\cos \theta d\omega d E ( p ) = L ( p , ω ) cos θ d ω 所以我们干脆把f r f_r f r
d L o ( x , ω o ) = f r ( x , ω i , ω o ) L i ( x , ω i ) cos θ d ω i dL_o(x,\omega_o) = f_r(x,\omega_i,\omega_o) L_i(x,\omega_i)\cos\theta d\omega_i d L o ( x , ω o ) = f r ( x , ω i , ω o ) L i ( x , ω i ) cos θ d ω i d L o ( x , ω o ) = f r ( x , ω i , ω o ) d E ( x , ω i ) dL_o(x,\omega_o) = f_r(x,\omega_i,\omega_o) dE(x,\omega_i) d L o ( x , ω o ) = f r ( x , ω i , ω o ) d E ( x , ω i ) 所以我们的材质算子是
f r ( x , ω i , ω o ) = d L o ( x , ω o ) d E ( x , ω i ) f_r(x,\omega_i,\omega_o) = \frac{dL_o(x,\omega_o)}{dE(x,\omega_i)} f r ( x , ω i , ω o ) = d E ( x , ω i ) d L o ( x , ω o ) f r f_r f r
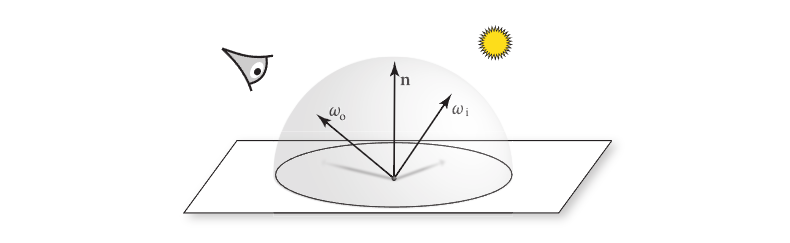
d L o ( x , ω o ) = f r ( x , ω i , ω o ) L i ( x , ω i ) cos θ d ω i dL_o(x,\omega_o) = f_r(x,\omega_i,\omega_o) L_i(x,\omega_i)\cos\theta d\omega_i d L o ( x , ω o ) = f r ( x , ω i , ω o ) L i ( x , ω i ) cos θ d ω i 它是只考虑微分立体角的区域,如果我们考虑更多区域,我们很容易想到一个点上接收的光来自以这个点为法线构成的平面上的半球区域,所以我们对这个半球区域进行积分就能得到
L o ( p , ω o ) = ∫ H 2 ( n ) f r ( p , ω i , ω o ) L i ( p , ω i ) cos θ i d ω i L_o(p, \omega_o) = \int_{\mathcal{H}^2(\mathbf{n}) } f_r(p,\omega_i, \omega_o) L_i(p,\omega_i) \cos\theta_i d\omega_i L o ( p , ω o ) = ∫ H 2 ( n ) f r ( p , ω i , ω o ) L i ( p , ω i ) cos θ i d ω i 这就是最反射方程,如果这个物体会自发光,我们加上自发光项(光的线性性),则会得到渲染方程
L o ( p , ω o ) = L e ( p , ω o ) + ∫ H 2 ( n ) f r ( p , ω i , ω o ) L i ( p , ω i ) cos θ i d ω i L_o(p, \omega_o) = L_e(p, \omega_o) + \int_{\mathcal{H}^2(\mathbf{n}) } f_r(p,\omega_i, \omega_o) L_i(p,\omega_i) \cos\theta_i d\omega_i L o ( p , ω o ) = L e ( p , ω o ) + ∫ H 2 ( n ) f r ( p , ω i , ω o ) L i ( p , ω i ) cos θ i d ω i BSSRDF# BRDF 只能表示物体的表面材质(只在同一点进同一点出),但是现实世界中不是这样的,现实世界中对于某些物体光线会进入物体的内部进行各种相互作用最后再射出物体(点A进点B出),对此我们需要一种新的模型,而bidirectional scattering surface reflectance distribution function (BSSRDF) 就是为了解决这个问题的模型
A A A S S S
d 2 L o ( x o , ω o ) = S ( x i , ω i , x o , ω o ) L i ( x i , ω i ) cos θ i d ω i d A ( x i ) d^2L_o(x_o, \omega_o) = S(x_i,\omega_i,x_o,\omega_o)L_i(x_i,\omega_i) \cos\theta_i d\omega_i dA(x_i) d 2 L o ( x o , ω o ) = S ( x i , ω i , x o , ω o ) L i ( x i , ω i ) cos θ i d ω i d A ( x i ) 还记得 Radiance 的这个式子吗
L ( p , ω ) = d 2 Φ ( p ) d ω d A cos θ L(p,\omega) = \frac{d^2\Phi(p)}{d\omega dA \cos \theta} L ( p , ω ) = d ω d A cos θ d 2 Φ ( p ) 所以我们的 BSSRDF 为
S ( x i , ω i , x o , ω o ) = d 2 L o ( x o , ω o ) d 2 Φ ( x i , ω i ) S(x_i,\omega_i,x_o,\omega_o) = \frac{d^2L_o(x_o, \omega_o)}{d^2 \Phi(x_i,\omega_i)} S ( x i , ω i , x o , ω o ) = d 2 Φ ( x i , ω i ) d 2 L o ( x o , ω o ) 对此我们的渲染方程应该改为
L o ( x o , ω o ) = L e ( x o , ω o ) + ∫ A ∫ H 2 ( n ) S ( x i , ω i , x o , ω o ) L i ( x i , ω i ) cos θ i d ω i d A ( x i ) L_o(x_o, \omega_o) = L_e(x_o, \omega_o) + \int_{A}\int_{\mathcal{H}^2(\mathbf{n}) } S(x_i,\omega_i,x_o,\omega_o) L_i(x_i,\omega_i) \cos\theta_i d\omega_i dA(x_i) L o ( x o , ω o ) = L e ( x o , ω o ) + ∫ A ∫ H 2 ( n ) S ( x i , ω i , x o , ω o ) L i ( x i , ω i ) cos θ i d ω i d A ( x i ) The Monte Carlo Integration 蒙特卡洛积分# 我们知道BRDF版的渲染方程是
L o ( p , ω o ) = L e ( p , ω o ) + ∫ H 2 ( n ) f r ( p , ω i , ω o ) L i ( p , ω i ) ( ω i ⋅ n ) d ω i L_o(p, \omega_o) = L_e(p, \omega_o) + \int_{\mathcal{H}^2(\mathbf{n}) } f_r(p,\omega_i, \omega_o) L_i(p,\omega_i) (\omega_i \cdot \mathbf{n}) d\omega_i L o ( p , ω o ) = L e ( p , ω o ) + ∫ H 2 ( n ) f r ( p , ω i , ω o ) L i ( p , ω i ) ( ω i ⋅ n ) d ω i 我们只看反射方程部分
L o ( p , ω o ) = ∫ H 2 ( n ) f r ( p , ω i , ω o ) L i ( p , ω i ) ( ω i ⋅ n ) d ω i L_o(p, \omega_o) = \int_{\mathcal{H}^2(\mathbf{n}) } f_r(p,\omega_i, \omega_o) L_i(p,\omega_i) (\omega_i \cdot \mathbf{n}) d\omega_i L o ( p , ω o ) = ∫ H 2 ( n ) f r ( p , ω i , ω o ) L i ( p , ω i ) ( ω i ⋅ n ) d ω i 这是一个积分方程,我们怎么计算这个积分呢?
由于我们的场景可能是一个茶壶,也可能是一个城市,而且这个方程我们观察它可以知道这是一个递归定义的方程,所以这个积分是没有解析解的,我们只能通过数值的方式来计算这个积分,而我们在这里最常用的数值积分方法就是 蒙特卡洛积分 ,我们假设你有基础的概率论水平,这就够了
The Monte Carlo Estimator# 事实上蒙特卡洛积分是一个估计量,而估计量是个随机变量,所以当你使用蒙特卡洛积分渲染图像的时候每次采样的样本不同,那么得到的结果也就不同,但是最终会收敛到正确的值,所以这个估计量是 无偏(unbias) 的,所以我们可以使用蒙特卡洛估计量去近似渲染方程所要的积分,接下来我们从数学出发验证一下我们上面提到的这些性质。
1. 蒙特卡洛估计量可以近似渲染方程的积分# 我们假设我们要积分的渲染方程的函数 f ( x ) f(x) f ( x )
I = ∫ Ω f ( x ) d x I = \int_{\Omega} f(x)dx I = ∫ Ω f ( x ) d x 我们可以对其进行变形
I = ∫ Ω f ( x ) p ( x ) p ( x ) d x I = \int_{\Omega} \frac{f(x)}{p(x)}p(x)dx I = ∫ Ω p ( x ) f ( x ) p ( x ) d x 熟悉概率论的一眼就能看出这是对随机变量 f ( x ) p ( x ) \frac{f(x)}{p(x)} p ( x ) f ( x )
I = E [ f ( X ) p ( X ) ] = ∫ Ω f ( x ) p ( x ) p ( x ) d x 其中 X 独立同分布服从 p ( x ) I = E[\frac{f(X)}{p(X)}] = \int_{\Omega} \frac{f(x )}{p(x)}p(x)dx \qquad \text{其中}X独立同分布服从p(x) I = E [ p ( X ) f ( X ) ] = ∫ Ω p ( x ) f ( x ) p ( x ) d x 其中 X 独立同分布服从 p ( x ) 而根据大数定律告诉我们:如果 X 1 , X 2 , . . . , X N X_1,X_2,...,X_N X 1 , X 2 , ... , X N p ( x ) p(x) p ( x )
1 N ∑ i = 1 N f ( X i ) p ( X i ) → N → ∞ E [ f ( x ) p ( x ) ] = I \frac{1}{N}\sum_{i=1}^N \frac{f(X_i)}{p(X_i)}\overset{N\to\infty }{\rightarrow}E[\frac{f(x)}{p(x)}] =I N 1 i = 1 ∑ N p ( X i ) f ( X i ) → N → ∞ E [ p ( x ) f ( x ) ] = I 我们使用 I ^ N \hat{I}_N I ^ N
I ^ N = 1 N ∑ i = 1 N f ( X i ) p ( X i ) 其中 X ∼ p ( x ) \hat{I}_N = \frac{1}{N}\sum_{i=1}^N \frac{f(X_i)}{p(X_i)}\qquad \text{其中}X \sim p(x) I ^ N = N 1 i = 1 ∑ N p ( X i ) f ( X i ) 其中 X ∼ p ( x ) 所以最终将渲染方程代入到蒙特卡洛积分中,可以得到
L ^ o ( p , ω o ) = L e ( p , ω o ) + 1 N ∑ i = 1 N f r ( p , ω i , ω o ) L i ( p , ω i ) ( ω i ⋅ n ) p ( ω i ) \hat{L}_o(p, \omega_o)=L_e(p,\omega_o)+\frac{1}{N}\sum_{i=1}^N\frac{f_r(p,\omega_i,\omega_o)L_i(p,\omega_i)(\omega_i \cdot \mathbf{n})}{p(\omega_i)} L ^ o ( p , ω o ) = L e ( p , ω o ) + N 1 i = 1 ∑ N p ( ω i ) f r ( p , ω i , ω o ) L i ( p , ω i ) ( ω i ⋅ n ) 其中
N N N p ( ω i ) p(\omega_i) p ( ω i ) 2. 蒙特卡洛估计量的无偏性# 这个我都不需要验证了因为我们就是从积分的定义中推导出来的,所以是无偏的。
如果非要验证也可以I ^ N \hat{I}_N I ^ N I I I
E [ I ^ N ] = E [ 1 N ∑ i = 1 N f ( X i ) p ( X i ) ] E[\hat{I}_N] = E\left[\frac{1}{N} \sum_{i=1}^{N} \frac{f(X_i)}{p(X_i)}\right] E [ I ^ N ] = E [ N 1 i = 1 ∑ N p ( X i ) f ( X i ) ] 因为期望具有线性性,且所有的样本都是从同一个分布 p ( x ) p(x) p ( x )
E [ I ^ N ] = 1 N ∑ i = 1 N E [ f ( X i ) p ( X i ) ] = 1 N ⋅ N ⋅ E [ f ( X ) p ( X ) ] = ∫ Ω f ( x ) p ( x ) p ( x ) d x = ∫ Ω f ( x ) d x = I E[\hat{I}_N] = \frac{1}{N} \sum_{i=1}^{N} E\left[\frac{f(X_i)}{p(X_i)}\right] = \frac{1}{N} \cdot N \cdot E\left[\frac{f(X)}{p(X)}\right] = \int_{\Omega} \frac{f(x)}{p(x)} p(x) dx = \int_{\Omega} f(x) dx = I E [ I ^ N ] = N 1 i = 1 ∑ N E [ p ( X i ) f ( X i ) ] = N 1 ⋅ N ⋅ E [ p ( X ) f ( X ) ] = ∫ Ω p ( x ) f ( x ) p ( x ) d x = ∫ Ω f ( x ) d x = I 3. 蒙特卡洛估计量的方差# 由于我们使用了采样那么肯定于真实值直接存在误差,体现在渲染的图上就是噪点,我们总是希望我们渲染的图是没有噪点的,所以研究一下蒙特卡洛估计量的方差是很有必要的Y i = f ( X i ) p ( X i ) Y_i = \frac{f(X_i)}{p(X_i)} Y i = p ( X i ) f ( X i ) Y i Y_i Y i
V a r [ I ^ N ] = V a r [ 1 N ∑ i = 1 N Y i ] Var[\hat{I}_N] = Var[\frac{1}{N}\sum_{i=1}^N Y_i] V a r [ I ^ N ] = V a r [ N 1 i = 1 ∑ N Y i ] 根据方差的性质:对于独立随机变量,和的方差等于方差之和,常数可以提出来再平方
V a r [ I ^ N ] = 1 N 2 V a r [ ∑ i = 1 N Y i ] = 1 N 2 ⋅ N ⋅ V a r [ Y ] = 1 N V a r [ f ( X ) p ( X ) ] Var[\hat{I}_N] = \frac{1}{N^2}Var[\sum_{i=1}^N Y_i] = \frac{1}{N^2}\cdot N\cdot Var[Y] = \frac{1}{N} Var[\frac{f(X)}{p(X)}] V a r [ I ^ N ] = N 2 1 V a r [ i = 1 ∑ N Y i ] = N 2 1 ⋅ N ⋅ V a r [ Y ] = N 1 V a r [ p ( X ) f ( X ) ] 我们令 σ 2 = V a r [ f ( X ) p ( X ) ] \sigma^2 = Var[\frac{f(X)}{p(X)}] σ 2 = V a r [ p ( X ) f ( X ) ]
V a r [ I ^ N ] = σ 2 N Var[\hat{I}_N] = \frac{\sigma^2}{N} V a r [ I ^ N ] = N σ 2 则标准差为:
σ I ^ N = σ 2 N = σ N \sigma_{\hat{I}_N} = \sqrt{\frac{\sigma^2}{N}} = \frac{\sigma}{\sqrt{N}} σ I ^ N = N σ 2 = N σ 从中我们可以看出两个点
蒙特卡洛积分的收敛速度是O ( 1 / N ) O(1/\sqrt{N}) O ( 1/ N )
方差由 V a r [ f ( x ) p ( x ) ] Var[ \frac{f(x)}{p(x)} ] V a r [ p ( x ) f ( x ) ] f ( x ) p ( x ) \frac{f(x)}{p(x)} p ( x ) f ( x )
降低方差加快收敛# 我们总是希望图片能越快收敛,所以我们需要寻找一些方法加速我们的渲染。
对光源采样 NEE# 还记得我们的Re0[0x01]吗?其中没有任何的优化方法,完全就是在半球上随机采样,这样会有很多问题,如果我们的光源非常的小,那么我们采样的很多光线是根本没法打到光源浪费掉了,所以我们可以改变一下我们采样的方式,我们可以直接对光源的区域进行采样,这样我们就可以避免很多无用的采样,这样我们就可以大大提高我们的渲染速度
ω = S r 2 \omega = \frac{S}{r^2} ω = r 2 S
其中S为一个球面区域的表面积
r为球的半径d ω d\omega d ω d A dA d A
d ω = cos θ d A r 2 d\omega = \frac{\cos \theta dA}{r^2} d ω = r 2 cos θ d A 其中
所以我们的积分方程需要改写为
L o ( p , ω o ) = ∫ A l i g h t f r ( p , ω i , ω o ) L i ( p , ω i ) cos θ i cos θ e r 2 d A L_o(p, \omega_o) = \int_{\mathcal{A_{light}} } f_r(p,\omega_i, \omega_o) L_i(p,\omega_i) \cos\theta_i \frac{\cos \theta_e }{r^2}dA L o ( p , ω o ) = ∫ A l i g h t f r ( p , ω i , ω o ) L i ( p , ω i ) cos θ i r 2 cos θ e d A 然后我们对每个 Shading Point 同时计算 BRDF 采样积分 和 对光源采样积分 然后把他们平均起来,当然简单的平均是不对的,后面我们介绍一种更为准确的方法。
这看似没问题了,但是并不是所有的 Shading Point都需要这一部分直接的光源的积分,因为这些Shading Point可能会被其他物体遮挡,不会被光源直射,所以我们需要考虑一个新的项 V ( x , x ′ ) V(x,x^{\prime}) V ( x , x ′ )
V ( x , x ′ ) = { 1 如果 x 和 x ′ 之间没有物体遮挡 0 否则 V(x,x^{\prime}) = \left\{\begin{matrix}
1 & \text{如果} x\text{和}x^{\prime}\text{之间没有物体遮挡} \\
0 & 否则
\end{matrix}\right. V ( x , x ′ ) = { 1 0 如果 x 和 x ′ 之间没有物体遮挡 否则 加上这一项后我们的渲染方程变为
L o ( x , ω o ) = ∫ A l i g h t f r ( x , ω i , ω o ) L i ( x , ω i ) cos θ i cos θ e ∣ ∣ x − x ′ ∣ ∣ 2 V ( x , x ′ ) d A L_o(x, \omega_o) = \int_{\mathcal{A_{light}} } f_r(x,\omega_i, \omega_o) L_i(x,\omega_i) \cos\theta_i \frac{\cos \theta_e }{||x-x^{\prime}||^2}V(x,x^{\prime})dA L o ( x , ω o ) = ∫ A l i g h t f r ( x , ω i , ω o ) L i ( x , ω i ) cos θ i ∣∣ x − x ′ ∣ ∣ 2 cos θ e V ( x , x ′ ) d A 分层采样 Stratified Sampling# 由于在渲染中我们采样的样本都是独立同分布的,所以他们的采样是完全随机的,如果采样的点全都聚集在一起就会造成浪费,有些区域稀疏或完全没有样本则会产生大量噪点。
读者也可以自行了解一下低差异序列,低差异序列用确定性的数学构造来强制均匀
重要性采样 Importance Sampling# 还记得我们在方差中提到的,如果p ( x ) p(x) p ( x ) f ( x ) f(x) f ( x ) f ( x ) f(x) f ( x ) f ( x ) f(x) f ( x ) p ( x ) p(x) p ( x )
多重重要性采样 Multiple Importance Sampling# 还记我们在对光源采样中提到的吗?对于同一个积分,我们有两种不同的采样策略,对 BRDF 采样 和 对光源采样。
由于我们对两种采样进行加权平均,所以这会组成一个新的估计量,也就是 多重采样的蒙特卡洛估计量
假设我们有多个采样策略:p 1 ( x ) , p 2 ( x ) , . . . , p n ( x ) p_1(x),p_2(x),...,p_n(x) p 1 ( x ) , p 2 ( x ) , ... , p n ( x )
I ^ M I S = ∑ i = 1 n 1 N i ∑ j = 1 N i w i ( x i , j ) f ( x i , j ) p i ( x i , j ) \hat{I}_{MIS} = \sum_{i=1}^n \frac{1}{N_i}\sum_{j=1}^{N_i}w_i(x_{i,j})\frac{f(x_{i,j})}{p_i(x_{i,j})} I ^ M I S = i = 1 ∑ n N i 1 j = 1 ∑ N i w i ( x i , j ) p i ( x i , j ) f ( x i , j ) 其中
p i ( x i , j ) p_i(x_{i,j}) p i ( x i , j ) w i ( x i , j ) w_i(x_{i,j}) w i ( x i , j ) ∑ i = 1 n w i ( x ) = 1 \sum_{i=1}^n w_i(x) = 1 ∑ i = 1 n w i ( x ) = 1 所以我们需要找到一个好的w i ( x i , j ) w_i(x_{i,j}) w i ( x i , j )
w i ( x ) = n i p i ( x ) ∑ k n k p k ( x ) w_i(x) = \frac{n_i p_i(x)}{\sum_k n_k p_k(x)} w i ( x ) = ∑ k n k p k ( x ) n i p i ( x ) 其中
n i n_i n i p i ( x ) p_i(x) p i ( x ) 除了 Balance Heuristic,Eric Veach还推导了更通用的形式 Power Heuristic
w i ( x ) = ( n i p i ( x ) ) β ∑ k ( n k p k ( x ) ) β w_i(x) = \frac{(n_i p_i(x))^\beta}{\sum_k (n_k p_k(x))^\beta} w i ( x ) = ∑ k ( n k p k ( x ) ) β ( n i p i ( x ) ) β 人们发现当 β = 2 \beta = 2 β = 2 β = 1 \beta = 1 β = 1
好了我们回到 Path Tracing 中,我们会分别对 BRDF 和 光源 进行采样,再使用 Power Heuristic β = 2 \beta = 2 β = 2
设采样策略1 BRDF 采样的 概率密度函数 pdf 为 p B R D F p_{BRDF} p B R D F
设采样策略2 光源 采样的 概率密度函数 pdf 为 p L i g h t p_{Light} p L i g h t N 1 = N 2 = 1 N_1 = N_2 = 1 N 1 = N 2 = 1
w B R D F = p B R D F 2 ( ω B R D F ) p B R D F 2 ( ω B R D F ) + p ω , L i g h t 2 ( ω B R D F ) w_{BRDF} = \frac{p_{BRDF}^2(\omega_{BRDF})}{p_{BRDF}^2(\omega_{BRDF})+p_{\omega, Light}^2(\omega_{BRDF})} w B R D F = p B R D F 2 ( ω B R D F ) + p ω , L i g h t 2 ( ω B R D F ) p B R D F 2 ( ω B R D F ) w L i g h t = p ω , L i g h t 2 ( ω L i g h t ) p B R D F 2 ( ω L i g h t ) + p ω , L i g h t 2 ( ω L i g h t ) w_{Light} = \frac{p_{\omega, Light}^2(\omega_{Light})}{p_{BRDF}^2(\omega_{Light})+p_{\omega, Light}^2(\omega_{Light})} w L i g h t = p B R D F 2 ( ω L i g h t ) + p ω , L i g h t 2 ( ω L i g h t ) p ω , L i g h t 2 ( ω L i g h t ) 但要注意的是
p L i g h t p_{Light} p L i g h t 1 / m 2 1/m^2 1/ m 2 p B R D F p_{BRDF} p B R D F 1 / s r 1/sr 1/ sr w B R D F , w L i g h t w_{BRDF},w_{Light} w B R D F , w L i g h t p B R D F , p L i g h t p_{BRDF},p_{Light} p B R D F , p L i g h t p L i g h t p_{Light} p L i g h t p ω ⋅ d ω = p A ⋅ d A p_\omega \cdot d\omega = p_A \cdot dA p ω ⋅ d ω = p A ⋅ d A 然后使用和 NEE 中类似的推导可知
p ω = p A ⋅ ∣ ∣ x − x ′ ∣ ∣ 2 cos θ e p_\omega = p_A \cdot \frac{||x - x'||^2}{\cos \theta_e} p ω = p A ⋅ cos θ e ∣∣ x − x ′ ∣ ∣ 2 所以
p ω , L i g h t = p L i g h t ⋅ ∣ ∣ x − x ′ ∣ ∣ 2 cos θ e p_{\omega, Light} = p_{Light} \cdot \frac{||x - x'||^2}{\cos \theta_e} p ω , L i g h t = p L i g h t ⋅ cos θ e ∣∣ x − x ′ ∣ ∣ 2 最终的 Radiance 估计为
L o ≈ w B R D F L B R D F + w L i g h t L L i g h t L_o \approx w_{BRDF}L_{BRDF} + w_{Light}L_{Light} L o ≈ w B R D F L B R D F + w L i g h t L L i g h t
其中 L B R D F , L L i g h t L_{BRDF},L_{Light} L B R D F , L L i g h t
Russian Roulette 俄罗斯轮盘赌# 回忆我们的渲染方程,这是一个递归定义的渲染方程,而它是无限递归下去的,但是我们的程序是不能无限递归的,所以我们一般会设置一个最大的递归深度,当递归深度达到这个深度时,我们就停止递归,而停止递归就会带来几个问题:
第一个问题就是有偏估计,假设最大递归深度为5 ,则相当于强行扔掉了 5 层之后的所有光路能量,渲染出来的画面会比真实物理世界偏暗
第二个问题就是效率低下,无论光线打到多么暗的材质,程序依然会傻傻地追踪满 5 层,浪费了大量的算力
而 Russian Roulette(RR) 就完美了解决了这个问题,俄罗斯轮盘赌我们经常在电视中看到:一个人和其他人赌命,在左轮手枪中塞几颗子弹,假设这个左轮手枪的弹容量为6,他塞了4颗子弹,则主角每次的生存概率为p = 2 6 p = \frac{2}{6} p = 6 2
这其实是就是伯努利试验,或者叫做 0-1 分布问题,在 Path Tracing 中我们也可以使用这个方法,我们递归一个光线,先对它进行一次 RR 测试,如果没命中则继续递归,如果命中则结束递归,而 RR 是无偏估计。
接下来我们来验证一下 RR 的无偏性L L L p p p [ 0 , 1 ) [0,1) [ 0 , 1 ) i i i
X R R = { L p 0 < i < p 0 p < i < 1 X_{RR} = \left\{\begin{matrix}
\frac{L}{p} & 0 < i < p\\
0 & p < i < 1
\end{matrix}\right. X R R = { p L 0 0 < i < p p < i < 1 这是一个离散型的随机变量,离散型的随机变量的期望非常好算:
E [ X R R ] = p ⋅ L p + ( 1 − p ) ⋅ 0 = L E[X_{RR}] = p\cdot \frac{L}{p} + (1-p)\cdot 0 = L E [ X R R ] = p ⋅ p L + ( 1 − p ) ⋅ 0 = L RR 估计量的期望的值等于真实值,所以 RR 估计量是一个无偏估计量
那么在使用 RR 后的蒙特卡洛估计量变为
L ^ o ( p , ω o ) = L e ( p , ω o ) + 1 N ∑ i = 1 N f r ( p , ω i , ω o ) L i ( p , ω i ) p R R cos θ i p p d f ( ω i ) \hat{L}_o(p, \omega_o)=L_e(p,\omega_o)+\frac{1}{N}\sum_{i=1}^N\frac{f_r(p,\omega_i,\omega_o)\frac{L_i(p,\omega_i)}{p_{RR}}\cos \theta_i}{p_{pdf}(\omega_i)} L ^ o ( p , ω o ) = L e ( p , ω o ) + N 1 i = 1 ∑ N p p df ( ω i ) f r ( p , ω i , ω o ) p R R L i ( p , ω i ) cos θ i 即
L ^ o ( p , ω o ) = L e ( p , ω o ) + 1 N ∑ i = 1 N f r ( p , ω i , ω o ) L i ( p , ω i ) cos θ i p p d f ( ω i ) ⋅ p R R \hat{L}_o(p, \omega_o)=L_e(p,\omega_o)+\frac{1}{N}\sum_{i=1}^N\frac{f_r(p,\omega_i,\omega_o)L_i(p,\omega_i)\cos \theta_i}{p_{pdf}(\omega_i)\cdot p_{RR}} L ^ o ( p , ω o ) = L e ( p , ω o ) + N 1 i = 1 ∑ N p p df ( ω i ) ⋅ p R R f r ( p , ω i , ω o ) L i ( p , ω i ) cos θ i 经过这次学习后你对渲染相关的理论知识应该有了一个大致的了解了,但是我们还是不知道怎么将这些理论应用到实际的工程中,但是现在已经天黑了,所以你准备明天再继续学如何将这些理论应用到工程中,非常的困倦,非常想睡觉,你的眼前一片模糊,等你再次睁开眼发现自己已经所处一个风格化的世界,看上去周围所有的东西都与现实世界中都不相同,但是还是你熟悉的那个教室,这时麦秧也走进了这个被风格化材质的教室。
虽然我们可以直观看出,但是为了练习一下公式,我们可以练习一下
 对此我们想要一个算子,将这个算子作用在一个入射光线上,就能得到另一个相应的出射光线。
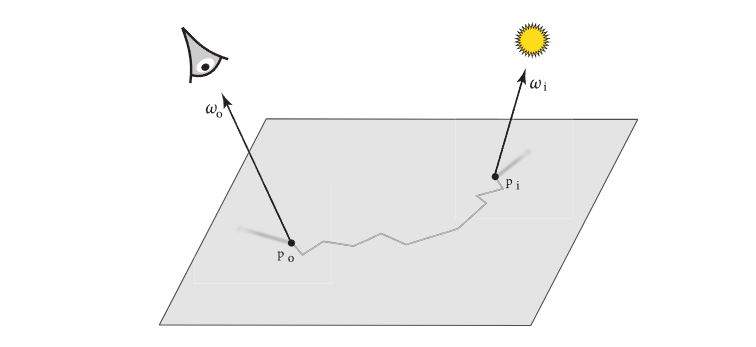 由于我们的渲染方程是想得到一个出射点的 Radiance 而 BSSRDF 并不是一一对应的,而是很多个入射点在物体内部单射后都有可能从出射点射出,所以我们需要对所有的入射点进行积分
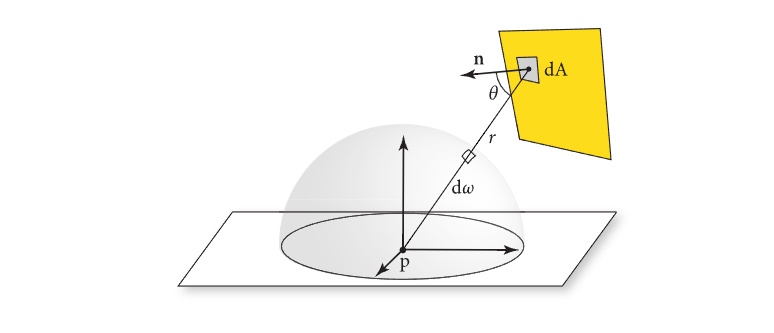 我们看看这幅图,一起来推导一下光源表面积和立体角之间的关系
我们知道立体角被定义为