这篇文章将会介绍蒙特卡洛积分法以及它的前置数学知识,并且看看它在计算机图形学中的应用
如果你有概率论与数理统计的基础,并且熟悉概率密度函数,估计量,无偏估计,期望,正态分布等概念,你可以直接跳到 蒙特卡洛积分法
估计量#
估计量(Estimator) 简单来说是一个使用样本随机变量来估计总体某种特征的一个函数
或者更结构化的表达是
估计量 θ^ 是定义在样本空间 Xn 上的一个实值函数g,它将样本随机变量(X1,X2,...,Xn)映射为对总体未知参数的估计
θ^=g(X1,X2,...,Xn)例如,定义一个估计量μ^=n1∑i=1nXi用于估计中国人的体重的总体均值
期望(Expectation) 描述了随机变量在多次重复试验中取值的理论平均水平
对于随机变量 X,其期望通常记作 E[X] 或 μ。根据变量类型的不同,其计算方式如下:
- 离散型随机变量:是各可能取值与其对应概率乘积的分量之和
E[X]=i∑xiP(X=xi)
- 连续型随机变量:是取值与概率密度函数乘积在整个定义域上的积分
E[X]=∫−∞∞xf(x)dx期望的性质#
- E(aX+bY)=aE(X)+bE(Y)
方差(Variance) 用于衡量随机变量与其数学期望(均值)之间的偏离程度,即取值的离散程度,对于随机变量 X,其方差记作 Var(X)
它的计算公式为:
Var(X)=E[(X−E[X])2]或者
Var(X)=E[X2]−(E[X])2方差的性质#
- Var(aX+b)=a2Var(X)
- Var(X+Y)=Var(X)+Var(Y)如果X和Y是独立的
无偏估计#
无偏(Unbiased) 是对一个估计量质量的评价,由于我们的估计量可能与真实值存在偏差,如果一个估计量与真实值的误差非常小,那么我们就称这个估计量是无偏的,或者叫做无偏估计量
怎么判断一个估计量是无偏的呢?当估计量的期望等于真实值的时候就是无偏的
E[θ^]=θ
概率密度函数#
概率密度函数(Probability Density Function) f(x) 描述了连续型随机变量 X 在某个确定的取值点附近的“可能性密度”
对于连续型随机变量,f(x) 在某一点的值并不直接等于概率,因为它被定义为,下面的积分,对一个点的积分等于0
P(a≤X≤b)=∫abf(x)dx
大数定律#
大数定律(Law of Large Numbers) 描述了随机变量序列的平均值在样本量趋于无穷大时,依概率收敛于其总体期望
严格的定义[出自概率论与数理统计 浙江大学 第5版]:
设 (X1,X2,...,Xn) 是独立同分布的随机变量序列,且 Xi 的期望为 μ,对于任意 ϵ>0,有
n→∞limP{n1k=1∑nXk−μ<ϵ}=1这意味着,只要我们不断增加样本点的数量,那么我们估计量 θ^ 就一定会越来越接近真实值 θ
蒙特卡洛积分#
蒙特卡洛积分(Monte Carlo Integration) 是一种利用采样来估算定积分值的数学方法。
想象一下,你想计算一个不规则图形的面积,但是这个图形的边缘曲线函数非常的复杂,用定积分是肯定积不出来的,这时候你使用一个[a,b]×[c,d]的矩形去框住这个图形,再通过某种方式投掷飞镖(假设飞镖扎中就一定不会偏移),如果我们投掷n次飞镖,并且每次飞镖都落入矩形框中,那么最后你统计在不规则图形中的飞镖数是 m,则不规则图形的面积S就是 S≈(b−a)(d−c)nm
在这个例子中涉及到了蒙特卡洛积分的很多思想
- 投飞镖:采样
- 以某种方式投飞镖:使用什么样子的概率密度函数进行采样
- 投掷n次飞镖:大数定律,当 n 足够大的时候,结果将无限接近真实值
这就是蒙特卡洛的核心精髓: 通过大量的随机采样,用离散的平均值来逼近连续的积分值
在图形学中我们经常需要计算这种复杂的积分
I=∫Ωf(x)dx由于 f(x) 包含复杂 BRDF ,入射光等。我们根本没法对他进行积分,那么这时蒙特卡洛积分就派上用场了,如果我们引入一个定义在区间 Ω 上的概率密度函数 p(x),我们可以将上述积分进行恒等变形,分子分母同时乘以 p(x):
I=∫Ωp(x)f(x)p(x)dx根据前面的期望的定义,我们把 p(x)f(x) 看作是一个整体,这正好是随机变量 p(X)f(X) 的期望,即:
I=E[p(X)f(X)]这样我们就将整个积分问题转化为了求一个随机变量的期望的问题,接下来根据大数定律,只要我们在 p(x) 的分布下进行 N 次独立采样,得到样本 (X1,X2,...,XN),我们就可以用这 N 个样本的平均值来作为总体期望的估计量
FN=N1i=1∑Np(Xi)f(Xi)这就是蒙特卡洛积分的基础公式,当采样数量 N→∞ 时,FN 就会无限收敛于真实的积分值 I。
验证无偏性#
我们只需对 FN 求一次期望,看看它是否等于真实值 I
E[FN]=E[N1i=1∑Np(Xi)f(Xi)]因为期望具有线性性,且所有的样本都是从同一个分布 p(x) 中独立采样的,所以
E[FN]=N1i=1∑NE[p(Xi)f(Xi)]=N1⋅N⋅E[p(X)f(X)]=∫Ωp(x)f(x)p(x)dx=∫Ωf(x)dx=I所以蒙特卡洛估计量 FN 是无偏的,只要你采样的点数足够多,蒙特卡洛积分法得出的结果一定是正确的。
再看投飞镖#
我们在学习完蒙特卡洛积分法之后,再回到投飞镖的例子,假设我们在[a,b]×[c,d]矩形区域中投掷飞镖是均匀分布的,那么此时联合概率密度函数为:
p(x)=(b−a)(d−c)1将其代入蒙特卡洛公式得到
FN=N(b−a)(d−c)i=1∑Nf(Xi)其中 f(Xi) 为
f(Xi)={1,0,点在图形内点在图形外收敛速度#
蒙特卡洛方法通过采样来获得积分值,在图形学中我们使用蒙特卡洛积分来渲染图形,那么需要采样多少次数,才能得到一个好的结果呢,随着采样得次数得到好的结果的速度如何呢?
收敛速度描述的是随着样本数增加,误差下降得有多快,我们通常使用标准差来描述,
而标准差是用来衡量估计量 FN(θ^) 偏离真值 I(θ) 的平均程度。
所以我们需要计算 FN的标准差,因为样本是独立的所以我们可以将利用方差的独立变量性质将方差代入求和号内部
V[FN]=Var[N1i=1∑NYi]=N21i=1∑NVar[Yi]由于每个 Yi 都来自同一个分布,它们的方差都相等,记为 σY2:
Var[FN]=N21⋅(N⋅σY2)=NσY2最后开方求得其标准差
σ[FN]=Var[FN]=NσY所以我们可以得到 FN 的收敛速度为O(N−1/2) ,这意味着如果你想让渲染画面的噪点(误差)减少一半,你需要增加 4 倍的采样数。
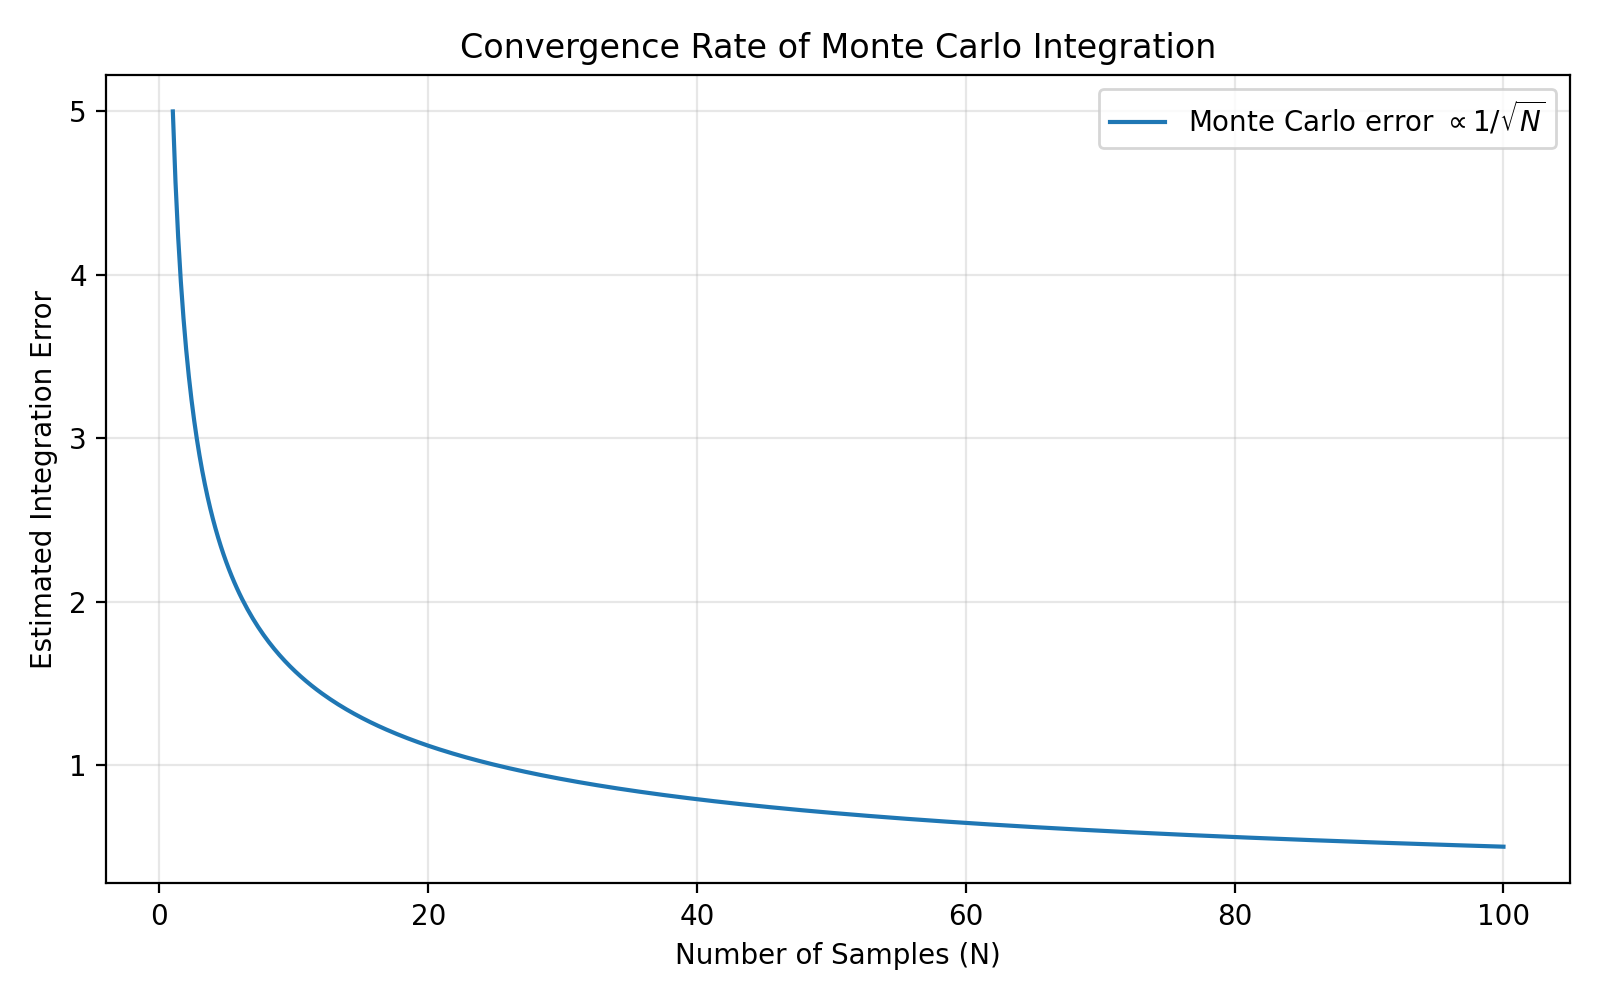 与其他的数值积分相比,蒙特卡洛的收敛速度始终是 O(N−1/2),这让他在高维的情况下表现得非常优秀,在图形渲染中,我们面对的往往是极高维度的积分问题,而传统的数值积分会随着维度的增加收敛速度大大增长
重要性采样#
蒙特卡洛的收敛速度始终是 NσY,但我们还想提高速度,那么我们就只能在分子上动手脚了,只需要让分子变小收敛速度就能加快
重要性采样 (Importance Sampling) 的核心思想就是:在对积分贡献更大的地方,进行更多的采样,且必须保证在 f(x)=0 情况下 p(x)>0
观察蒙特卡洛公式
FN=N1i=1∑Np(Xi)f(Xi)如果 p(x),其结构与 f(x) 尽可能相似,那么比值 p(x)f(x) 就会趋近于一个常数,如果 p(x)=cf(x),那么方差就是 0